Publications

2026

  1. arXiv 2608
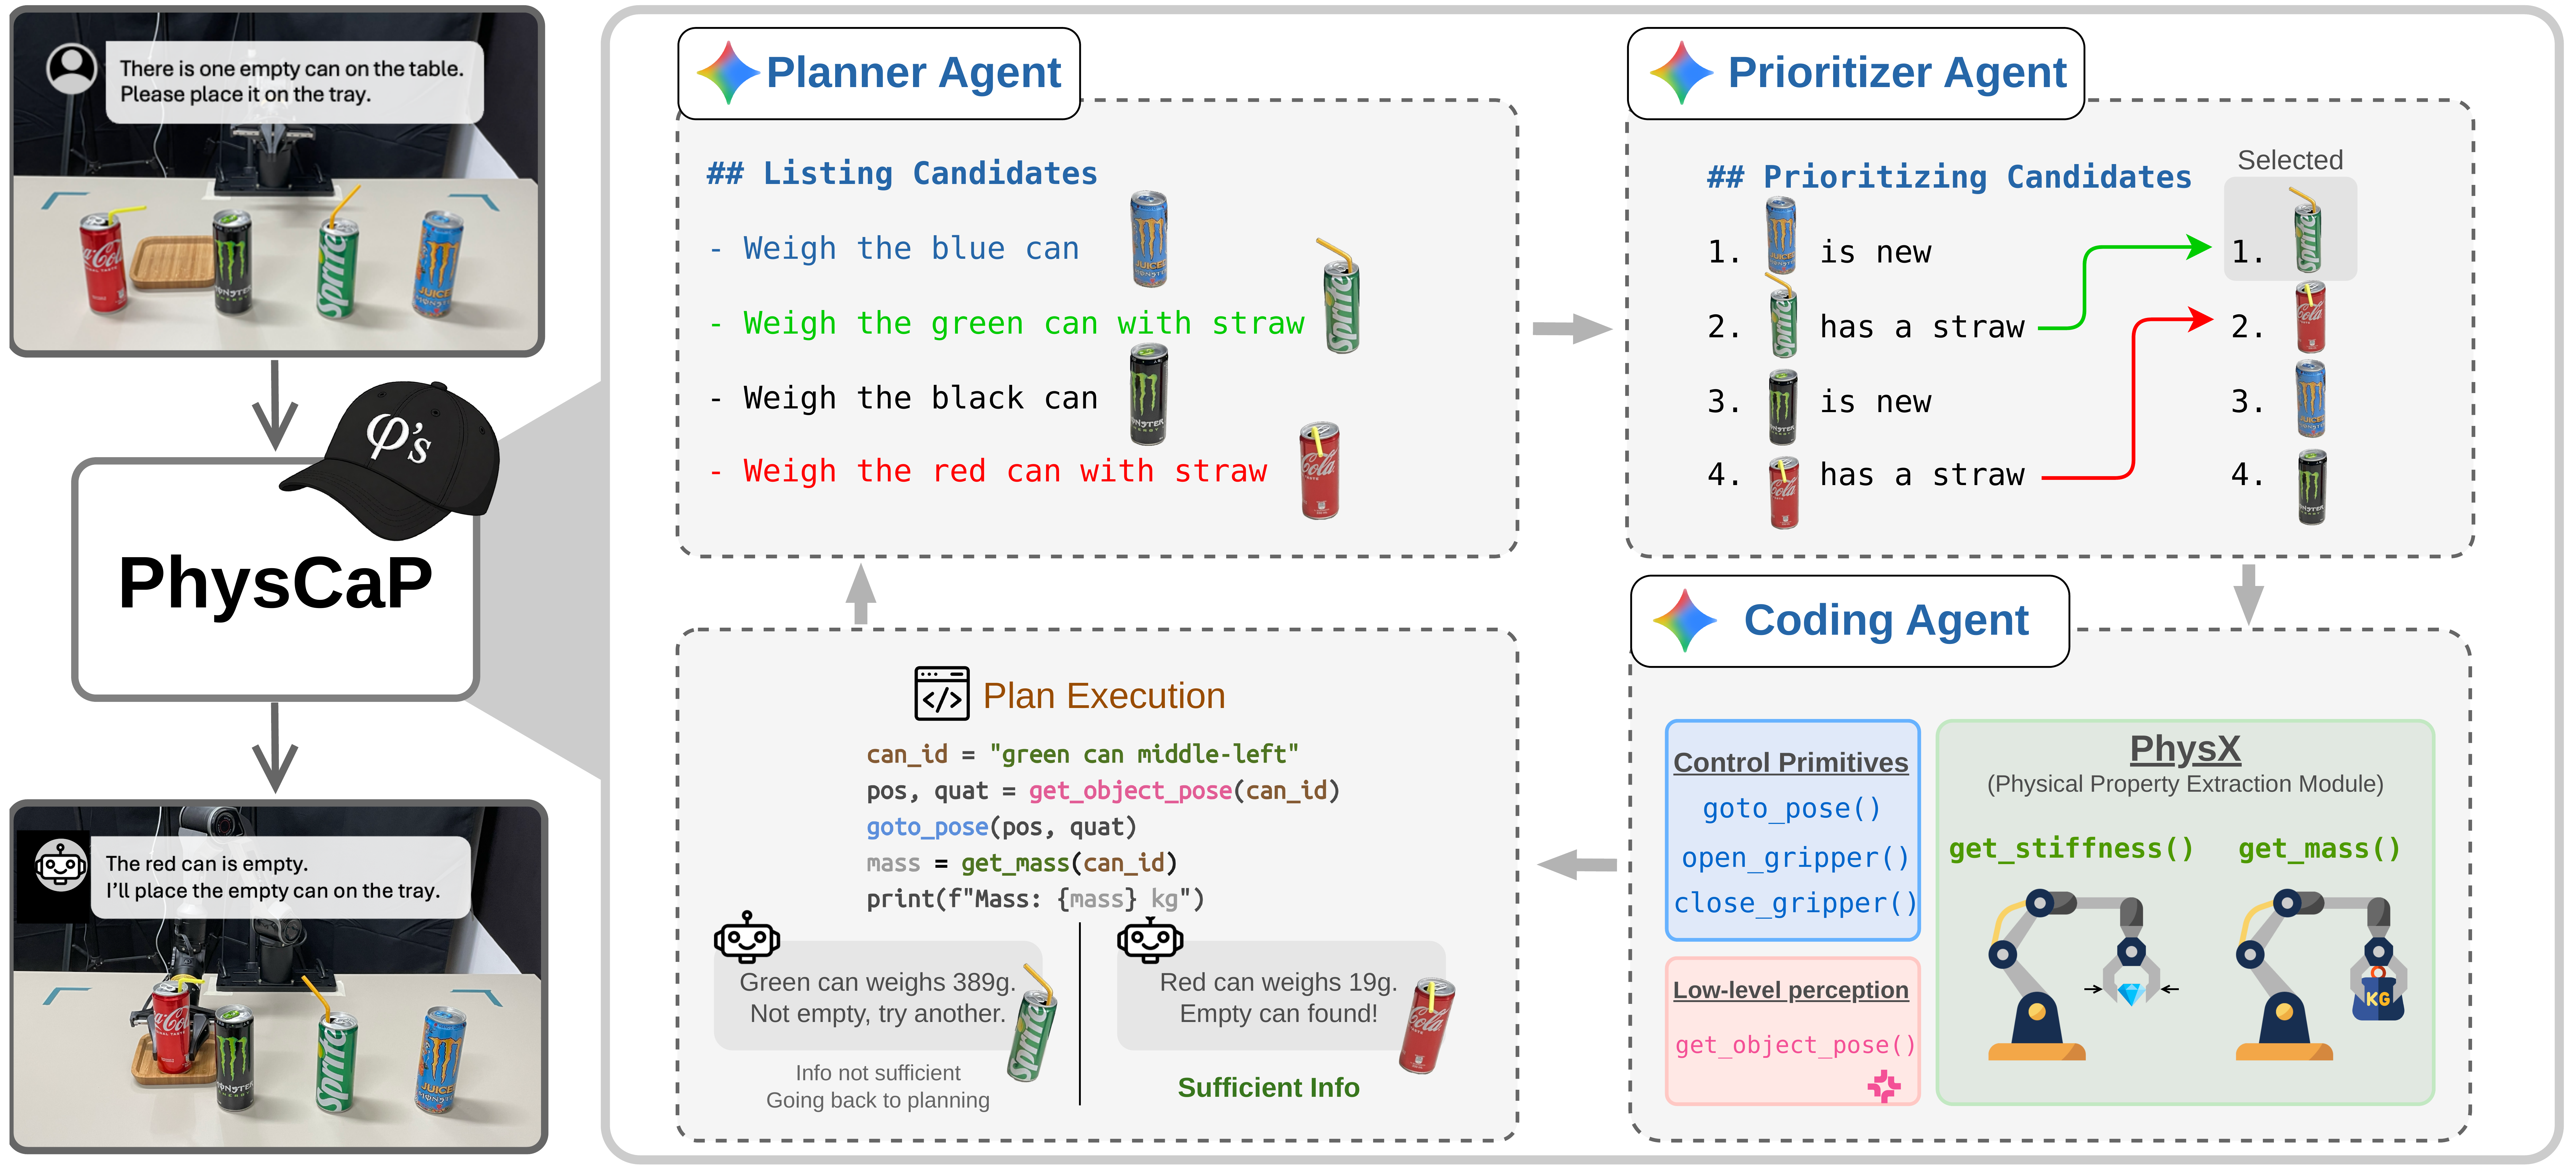
    physcap-framework.png
    PhysCaP: Grounding Code-as-Policy Agent with Physics-Informed Exploration
    Chen-Yu Lin, Jing-Wen Chen , Hsueh-En Chang , Hung-An Chen , Sheng-Hsun Chang, Chi-Pin Huang, Fu-En Yang , Min-Hung Chen , Yi-Ting Chen, Yu-Chiang Frank Wang, and Shao-Hua Sun
    arXiv preprint arXiv:2608.21031, 2026
  2. CVPR 2026
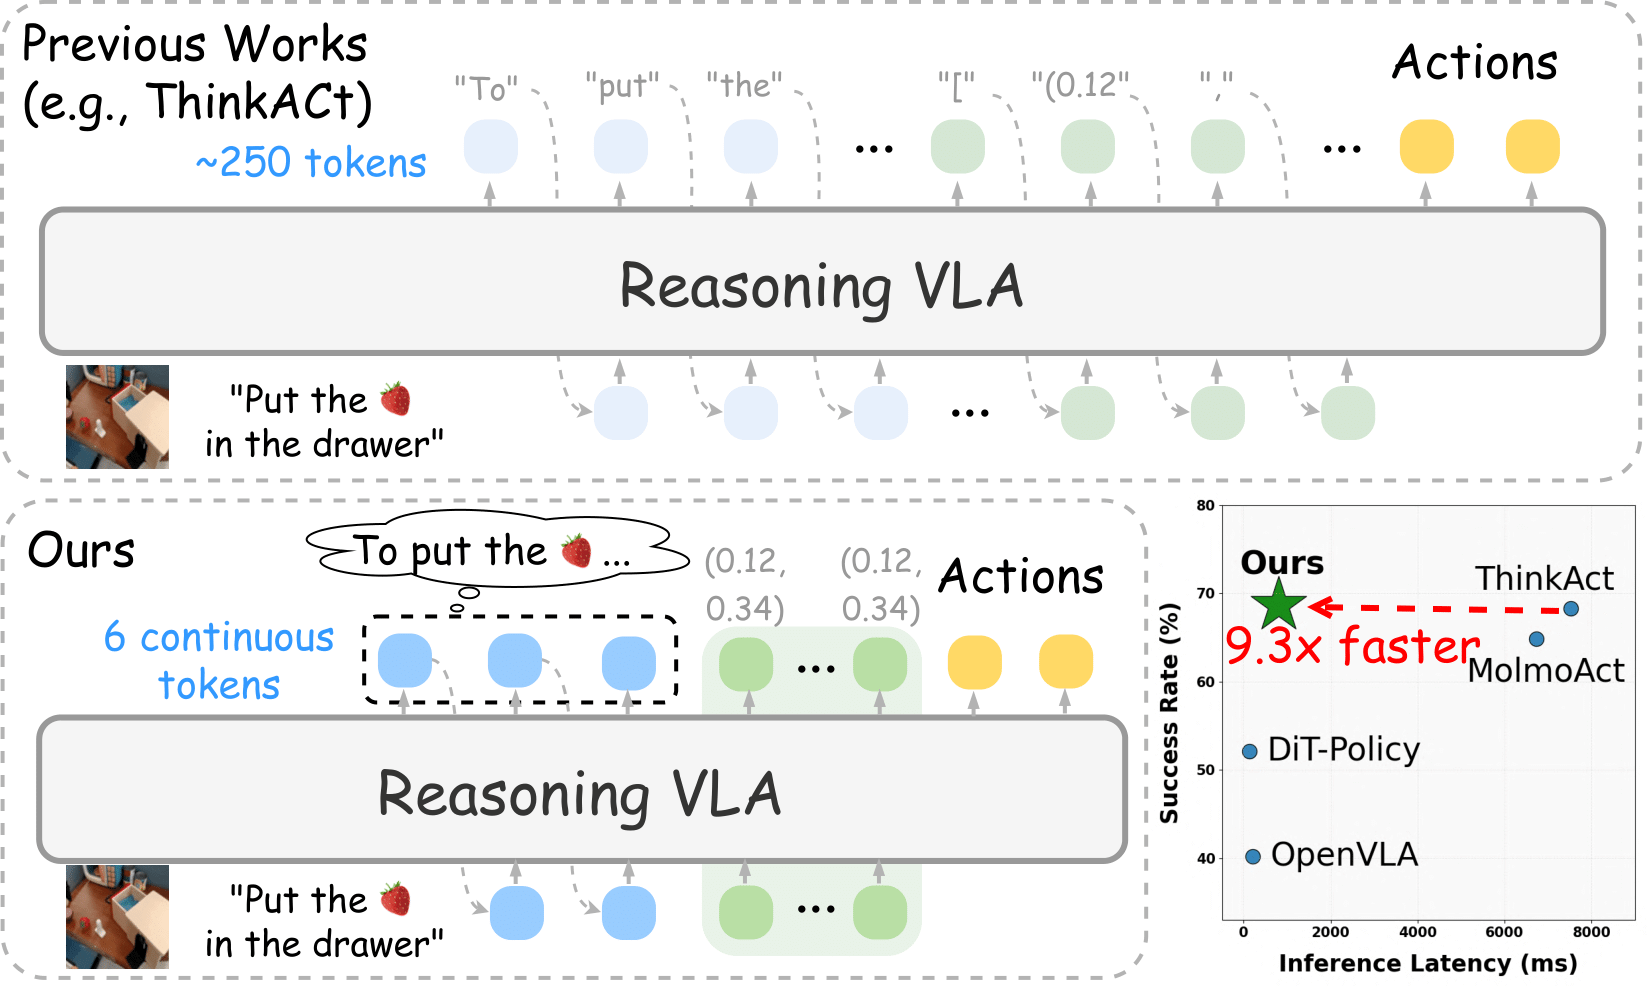
    fast-thinkact-teaser.png
    Fast-ThinkAct: Efficient Vision-Language-Action Reasoning via Verbalizable Latent Planning
    In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2026
  3. WACV 2026
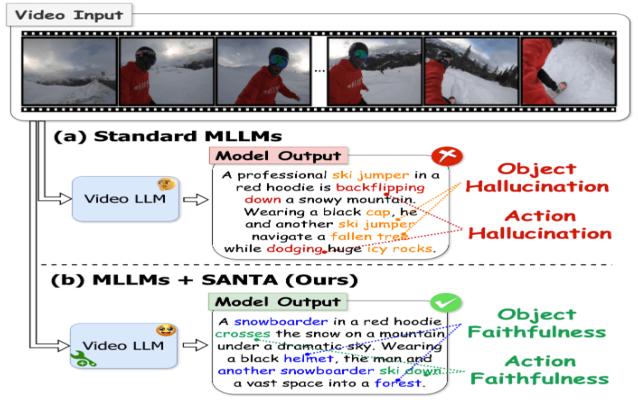
    santa.png
    Mitigating Object and Action Hallucinations in Multimodal LLMs via Self-Augmented Contrastive Alignment
    In Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV), 2026
  4. WACV 2026
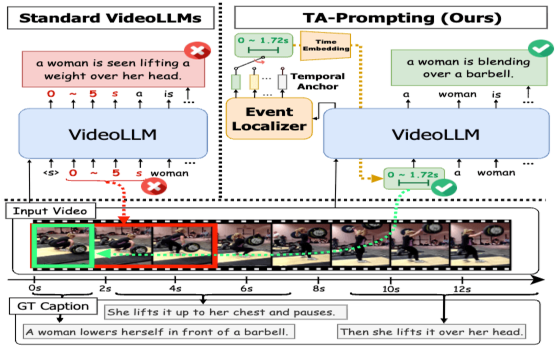
    ta-prompting.png
    TA-Prompting: Enhancing Video Large Language Models for Dense Video Captioning via Temporal Anchors
    In Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV), 2026
2025

  1. NeurIPS 2025
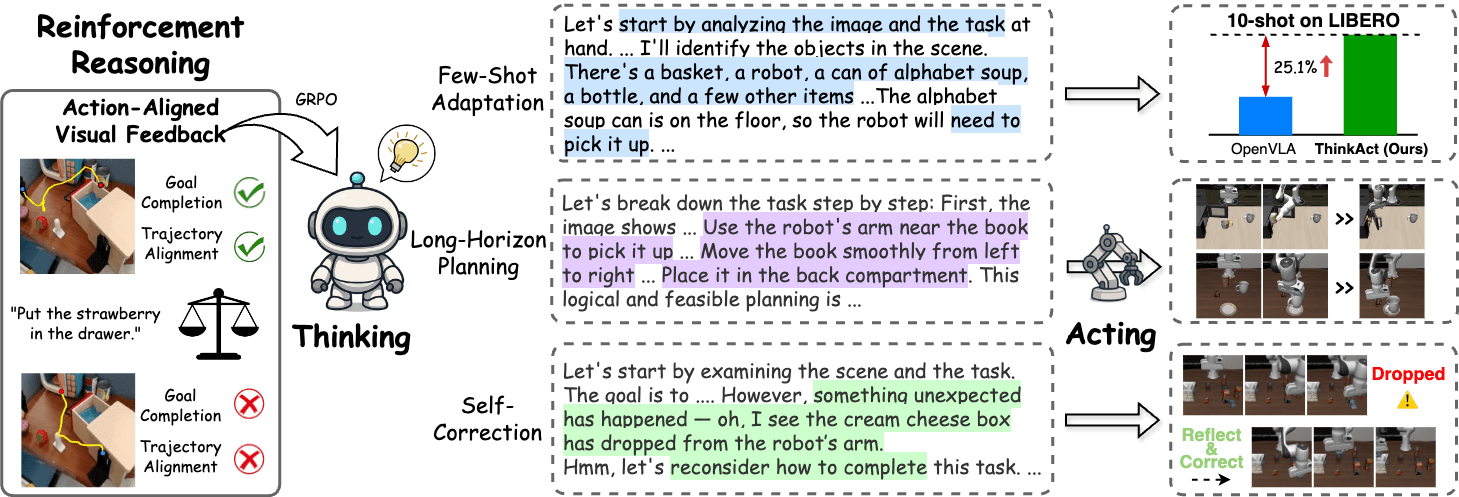
    thinkact-teaser.png
    ThinkAct: Vision-Language-Action Reasoning via Reinforced Visual Latent Planning
    Advances in Neural Information Processing systems (NeurIPS), 2025
  2. ICCV 2025
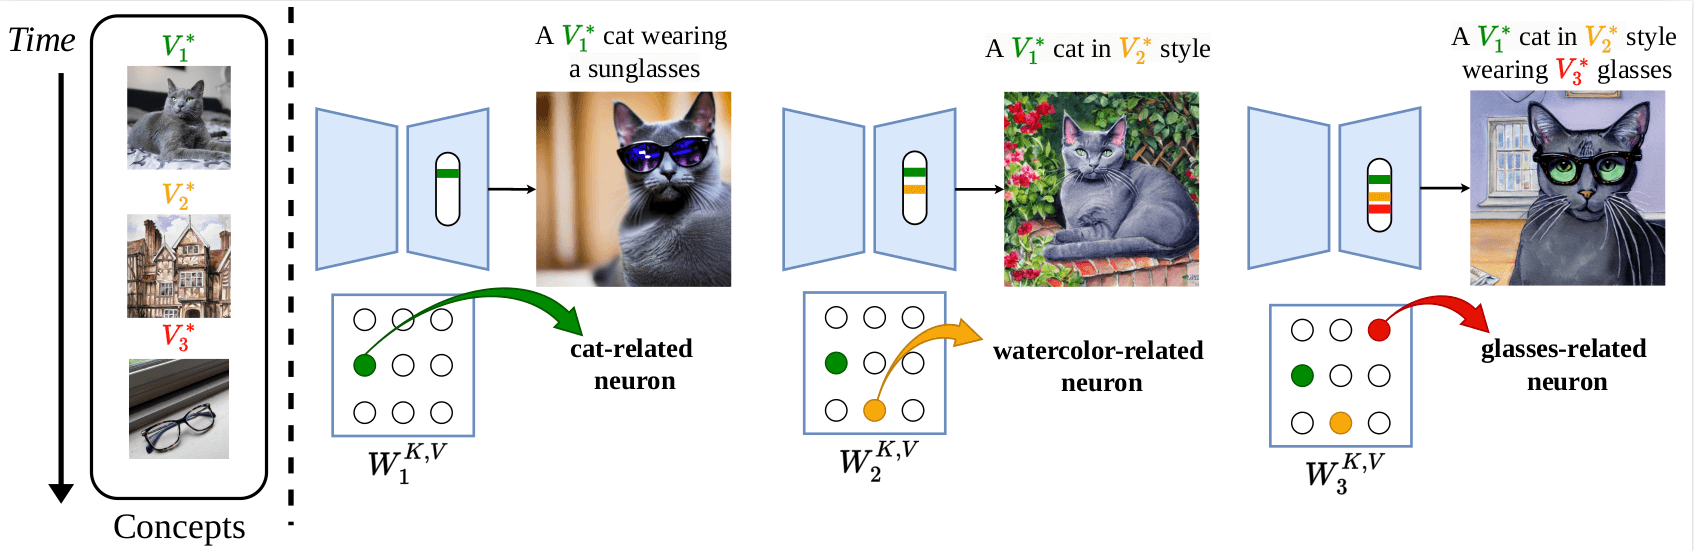
    condense-teaser.png
    Continual Personalization for Diffusion Models
    Yu-Chien Liao , Jr-Jen Chen, Chi-Pin Huang, Ci-Siang Lin , Meng-Lin Wu, and Yu-Chiang Frank Wang
    In Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), 2025
  3. ICCVW 2025
    motionmatcher-preview.gif
    MotionMatcher: Motion Customization of Text-to-Video Diffusion Models via Motion Feature Matching
    Yen-Siang Wu, Chi-Pin Huang, Fu-En Yang, and Yu-Chiang Frank Wang
    ICCV 2025 Workshop on P13N: Personalization in Generative AI, 2025
  4. CVPR 2025
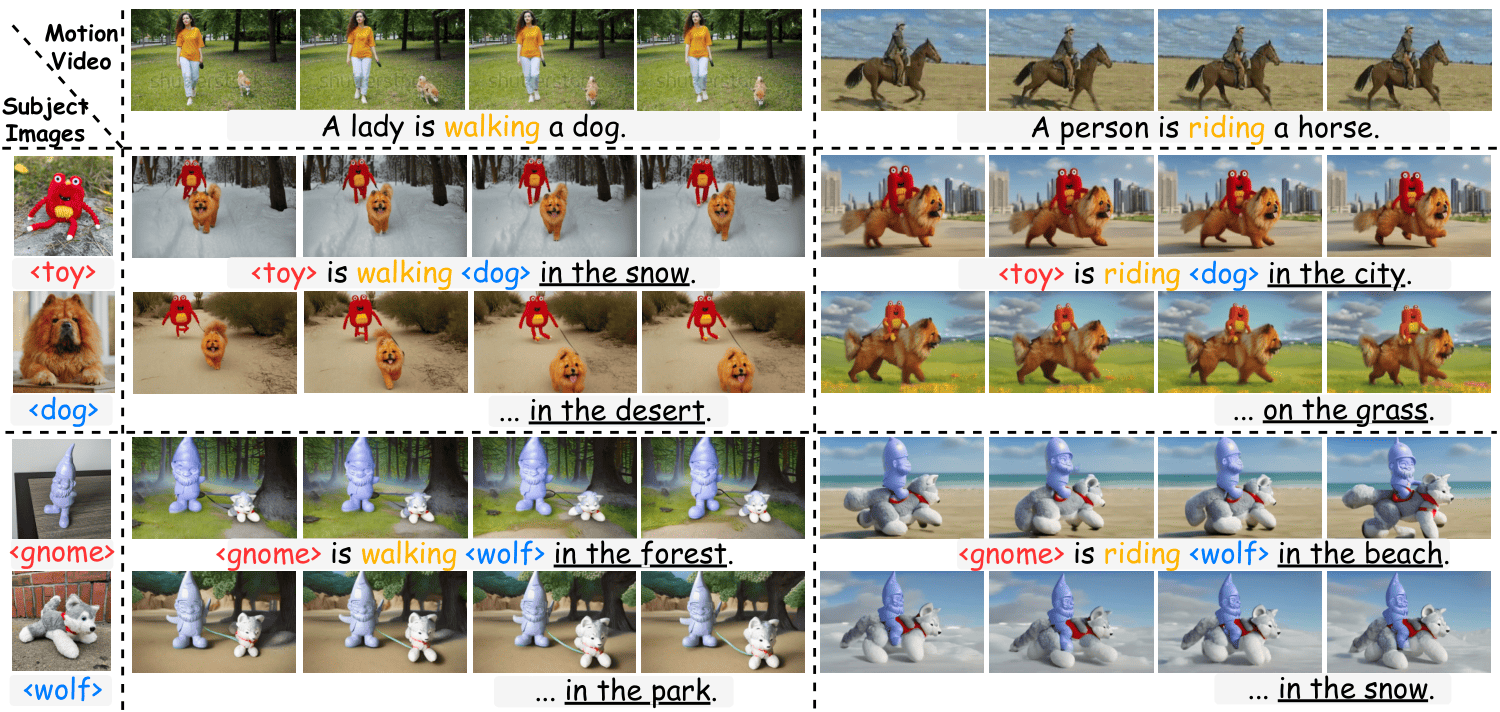
    videomage-teaser.png
    VideoMage: Multi-Subject and Motion Customization of Text-to-Video Diffusion Models
    In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2025

2024

  1. ECCV 2024
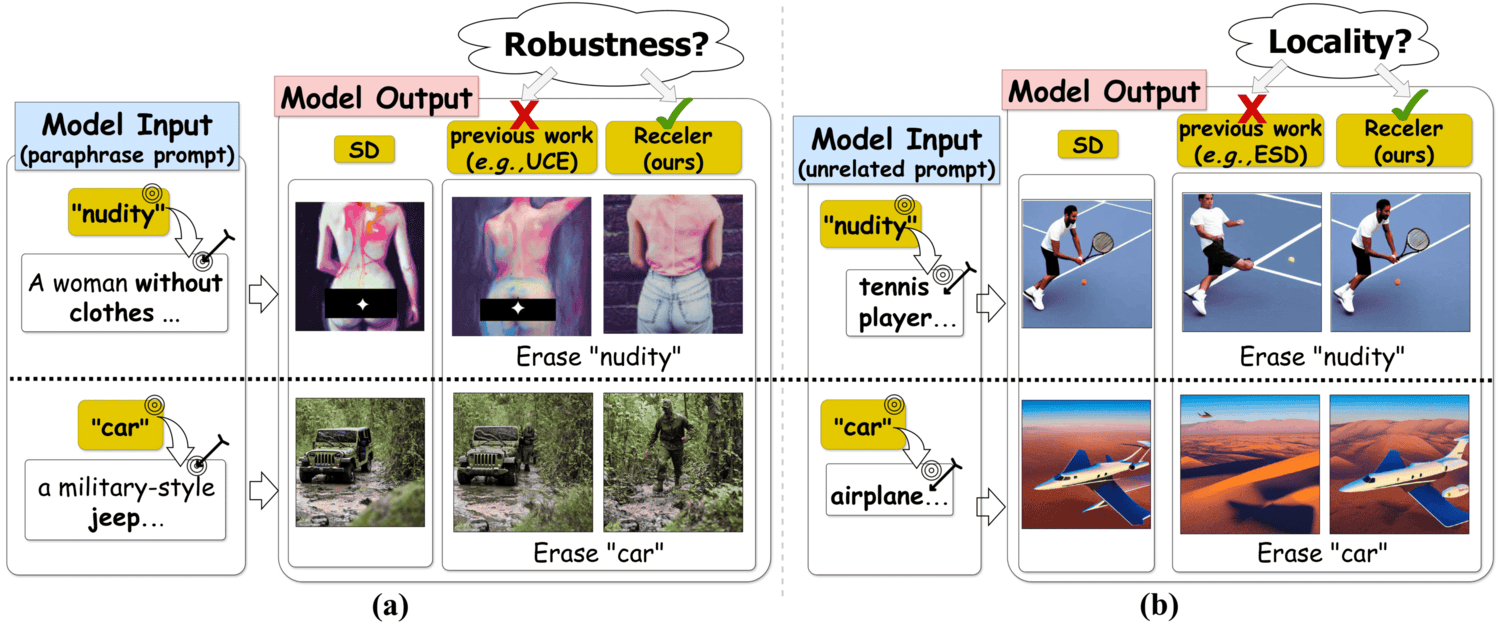
    receler-teaser.png
    Receler: Reliable concept erasing of text-to-image diffusion models via lightweight erasers
    In European Conference on Computer Vision (ECCV), 2024
  2. ECCV 2024
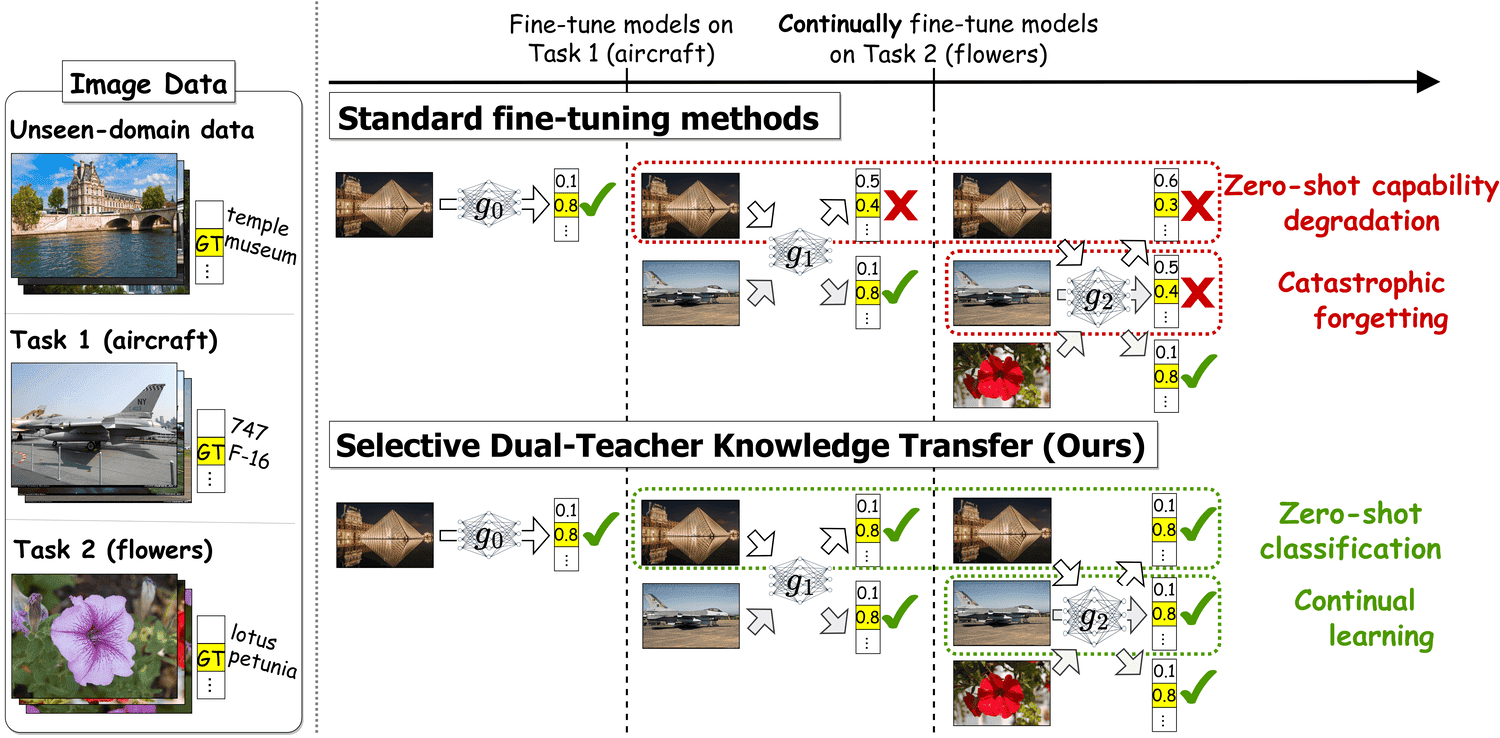
    snd-teaser.png
    Select and distill: Selective dual-teacher knowledge transfer for continual learning on vision-language models
    Yu-Chu Yu, Chi-Pin Huang , Jr-Jen Chen, Kai-Po Chang, Yung-Hsuan Lai, Fu-En Yang, and Yu-Chiang Frank Wang
    In European Conference on Computer Vision (ECCV), 2024
  3. ICLR 2024
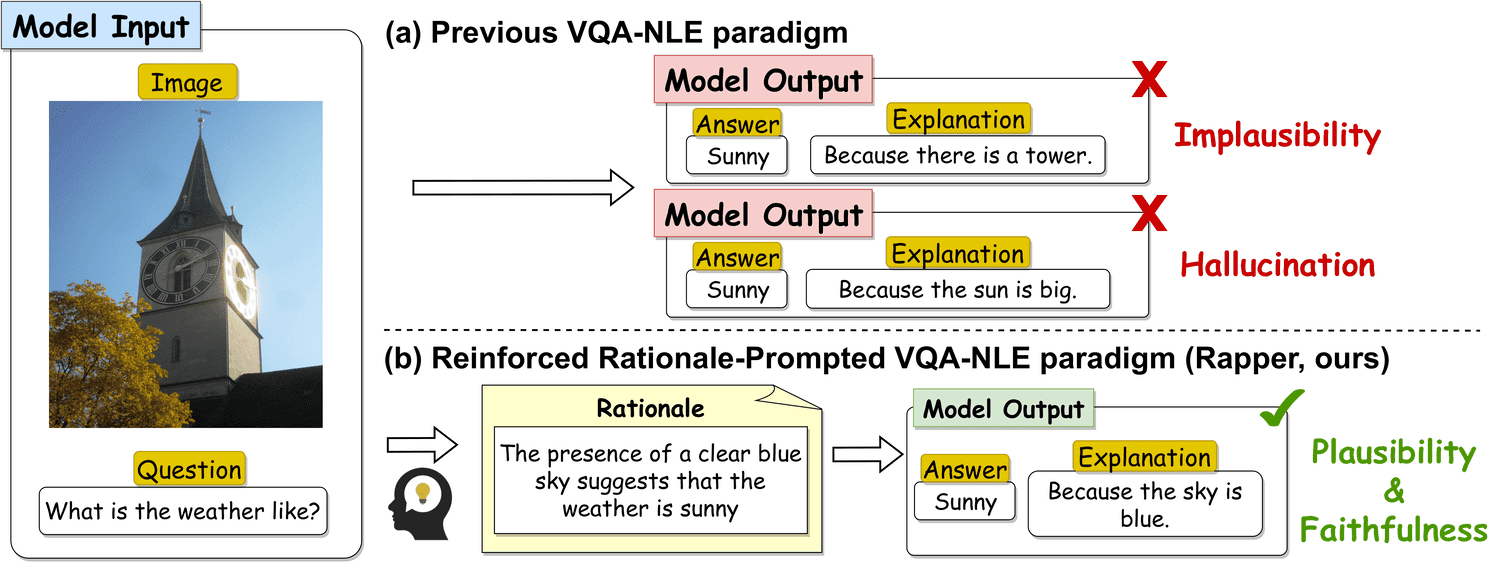
    rapper-teaser.png
    Rapper: Reinforced rationale-prompted paradigm for natural language explanation in visual question answering
    In The Twelfth International Conference on Learning Representations (ICLR), 2024